PostgreSQL Go、pgx/v5、pgxpool 与生产级数据库访问层
从 goroutine、pgxpool、PostgreSQL Backend、连接池排队、Rows、事务、SQLSTATE、PgBouncer、健康检查与优雅停机出发,理解 Go 生产级 PostgreSQL 访问层设计。
第 16 章:Go、pgx/v5、pgxpool 与生产级数据库访问层
结论核对,基准日期:2026 年 6 月 20 日
- PostgreSQL 当前生产基线可写为 PostgreSQL 18,当前维护版本为 18.4;PostgreSQL 19 仍处于 Beta 1,不应作为生产基线。PostgreSQL 14 将于 2026 年 11 月 12 日停止维护。(PostgreSQL)
- 当前稳定 Go 版本为 Go 1.26.4;本章代码只依赖稳定语言能力,不把 Go 补丁版本写入项目设计。(Go语言)
- 当前 pgx/v5 API 已包含
MinIdleConns、PingTimeout、PrepareConn、CanceledAcquireCount、EmptyAcquireWaitTime等能力。配置字段的准确名称是MaxConnLifetimeJitter,不是泛化的 “Lifetime Jitter”。(Go Packages)pgx.Conn不支持并发调用;并发安全的是pgxpool.Pool。(Go Packages)- “PgBouncer Transaction Pooling 不支持预编译语句”已经不是完整结论。当前 PgBouncer 可以在启用
max_prepared_statements后跟踪协议级命名预编译语句,但 SQL 级PREPARE/EXECUTE/DEALLOCATE、会话级SET、LISTEN、会话 Advisory Lock 等仍不兼容 Transaction Pooling。(PgBouncer)
1. 本章定位
本章解决的不是“如何执行一条 SQL”,而是以下生产问题:
- 如何在大量 goroutine 与有限 PostgreSQL Backend Process 之间建立稳定边界;
- 如何防止连接泄漏、连接风暴、连接池耗尽和长事务占池;
- 如何正确处理
Rows、BatchResults、事务、超时和 SQLSTATE; - 如何在数据库重启、网络中断和 Failover 后恢复连接;
- 如何监控连接池排队,而不是只监控数据库连接数;
- 如何在 PgBouncer、直接连接和读写分离之间选择协议模式;
- 如何设计 readiness、liveness 和优雅停机。
本章依赖:
- 第 1 章的 PostgreSQL 每连接一个 Backend Process 模型;
- 第 9~11 章的事务、MVCC、锁和死锁;
- 第 13 章的提交路径及 Commit 结果不确定;
- 第 15 章的应用版本与 Schema 兼容。
本章不深入:
- 批量写入方法的极限优化,留到第 17 章;
- PgBouncer 全部容量参数,留到第 18 章;
- 分片连接池,留到第 19 章;
- 复制读路由和 LSN 一致性,留到第 21 章;
- Patroni Failover 编排,留到第 23 章。
2. 可验证的学习目标
完成本章后,应能够:
- 解释 goroutine、连接池连接、PostgreSQL Backend、活跃查询和 TPS 的区别;
- 根据数据库总连接预算、应用实例数和压测结果推导
MaxConns; - 使用
pgxpool.ParseConfig创建生产级连接池; - 正确使用
Acquire、AcquireFunc、Query、QueryRow、Rows、Tx、Batch和CopyFrom; - 通过
Pool.Stat()判断池排队、连接抖动和连接池耗尽; - 使用
errors.As、*pgconn.PgError和 SQLSTATE 分类错误; - 解释为什么
Commit返回错误不等于事务一定未提交; - 验证 Transaction Pooling 下哪些会话状态不可用;
- 在数据库重启后观察旧连接失效和新连接建立;
- 实现有超时、监控、预热、健康检查和优雅关闭的 Go 数据访问层。
3. 核心术语
| 中文名称 | 英文名称 | 准确定义 | 容易混淆的概念 | 所属层次 |
|---|---|---|---|---|
| 物理连接 | Physical Connection | 客户端到 PostgreSQL 或 PgBouncer 的 TCP/Unix Socket 与协议会话 | 业务请求 | 网络/协议 |
| 数据库会话 | Session | 物理连接存续期间的会话状态,包括 GUC、临时表、Prepared Statement 等 | 事务 | PostgreSQL |
| 事务 | Transaction | 一个原子提交或回滚的数据库工作单元 | 连接 | SQL/MVCC |
| 连接池 | Connection Pool | 复用有限物理连接并让调用方等待获取的组件 | PgBouncer | 应用进程 |
| 池租约 | Lease | goroutine 暂时独占一个池连接的时间段 | 数据库锁 | 应用并发 |
| 获取等待 | Acquire Wait | 因池中无可用连接而等待的时间 | SQL 执行时间 | 应用排队 |
| 活跃连接 | Acquired Connection | 当前已从 pgxpool 借出但尚未归还的连接 | PostgreSQL active 状态 | 应用池 |
| 空闲连接 | Idle Connection | 已建立、当前未被借出的池连接 | idle in transaction | 应用池 |
| 会话状态 | Session State | 绑定物理连接的 SET、临时表、LISTEN、会话锁等 | 事务局部状态 | PostgreSQL |
| 查询执行模式 | Query Execution Mode | pgx 选择缓存预编译、描述缓存、Extended 或 Simple Protocol 的策略 | PostgreSQL Planner 计划模式 | 驱动 |
| 语句缓存 | Statement Cache | pgx 按 SQL 文本缓存协议级预编译语句 | PostgreSQL Plan Cache | 驱动/服务端 |
| 描述缓存 | Description Cache | 缓存参数和结果类型描述,而不一定保留服务端命名语句 | 业务结果缓存 | 驱动 |
| 连接风暴 | Connection Storm | 大量实例同时建立或重建连接,压垮认证、TLS、Backend 创建或数据库上限 | 高 SQL QPS | 故障行为 |
| 结果不确定 | Outcome Unknown | 客户端未能确认服务端是否完成 Commit 或语句 | 明确回滚 | 分布式故障 |
| Bulkhead | 舱壁隔离 | 用独立池或独立并发预算隔离不同工作负载 | 读写分离 | 架构 |
| Backpressure | 背压 | 下游饱和时让上游排队、降级或拒绝,而不是无限增加并发 | 限流 | 流量控制 |
4. 整体心智模型
4.1 goroutine、连接池与 PostgreSQL Backend
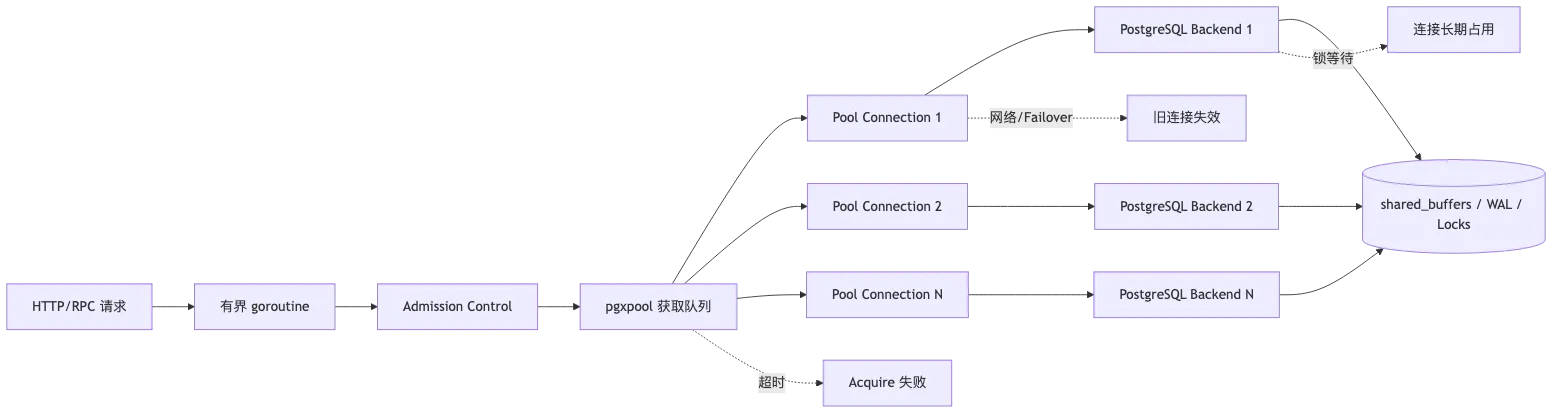
关键边界:
- 一个应用实例可以有数千个 goroutine;
- 但其
pgxpool可能只有 10~30 个连接; - 每个直连 PostgreSQL 的物理连接通常对应一个 Backend Process;
- 一个连接同一时刻只能安全执行一条正常命令流;
- goroutine 超过
MaxConns后应在池或应用准入层排队; - 增加连接数只增加并发进入数据库的能力,不保证增加吞吐。
pgxpool.Pool 是并发安全的,而单个 pgx.Conn 不是;因此不应让多个 goroutine 同时使用同一个 pgx.Conn。(Go Packages)
4.2 一次查询的控制流
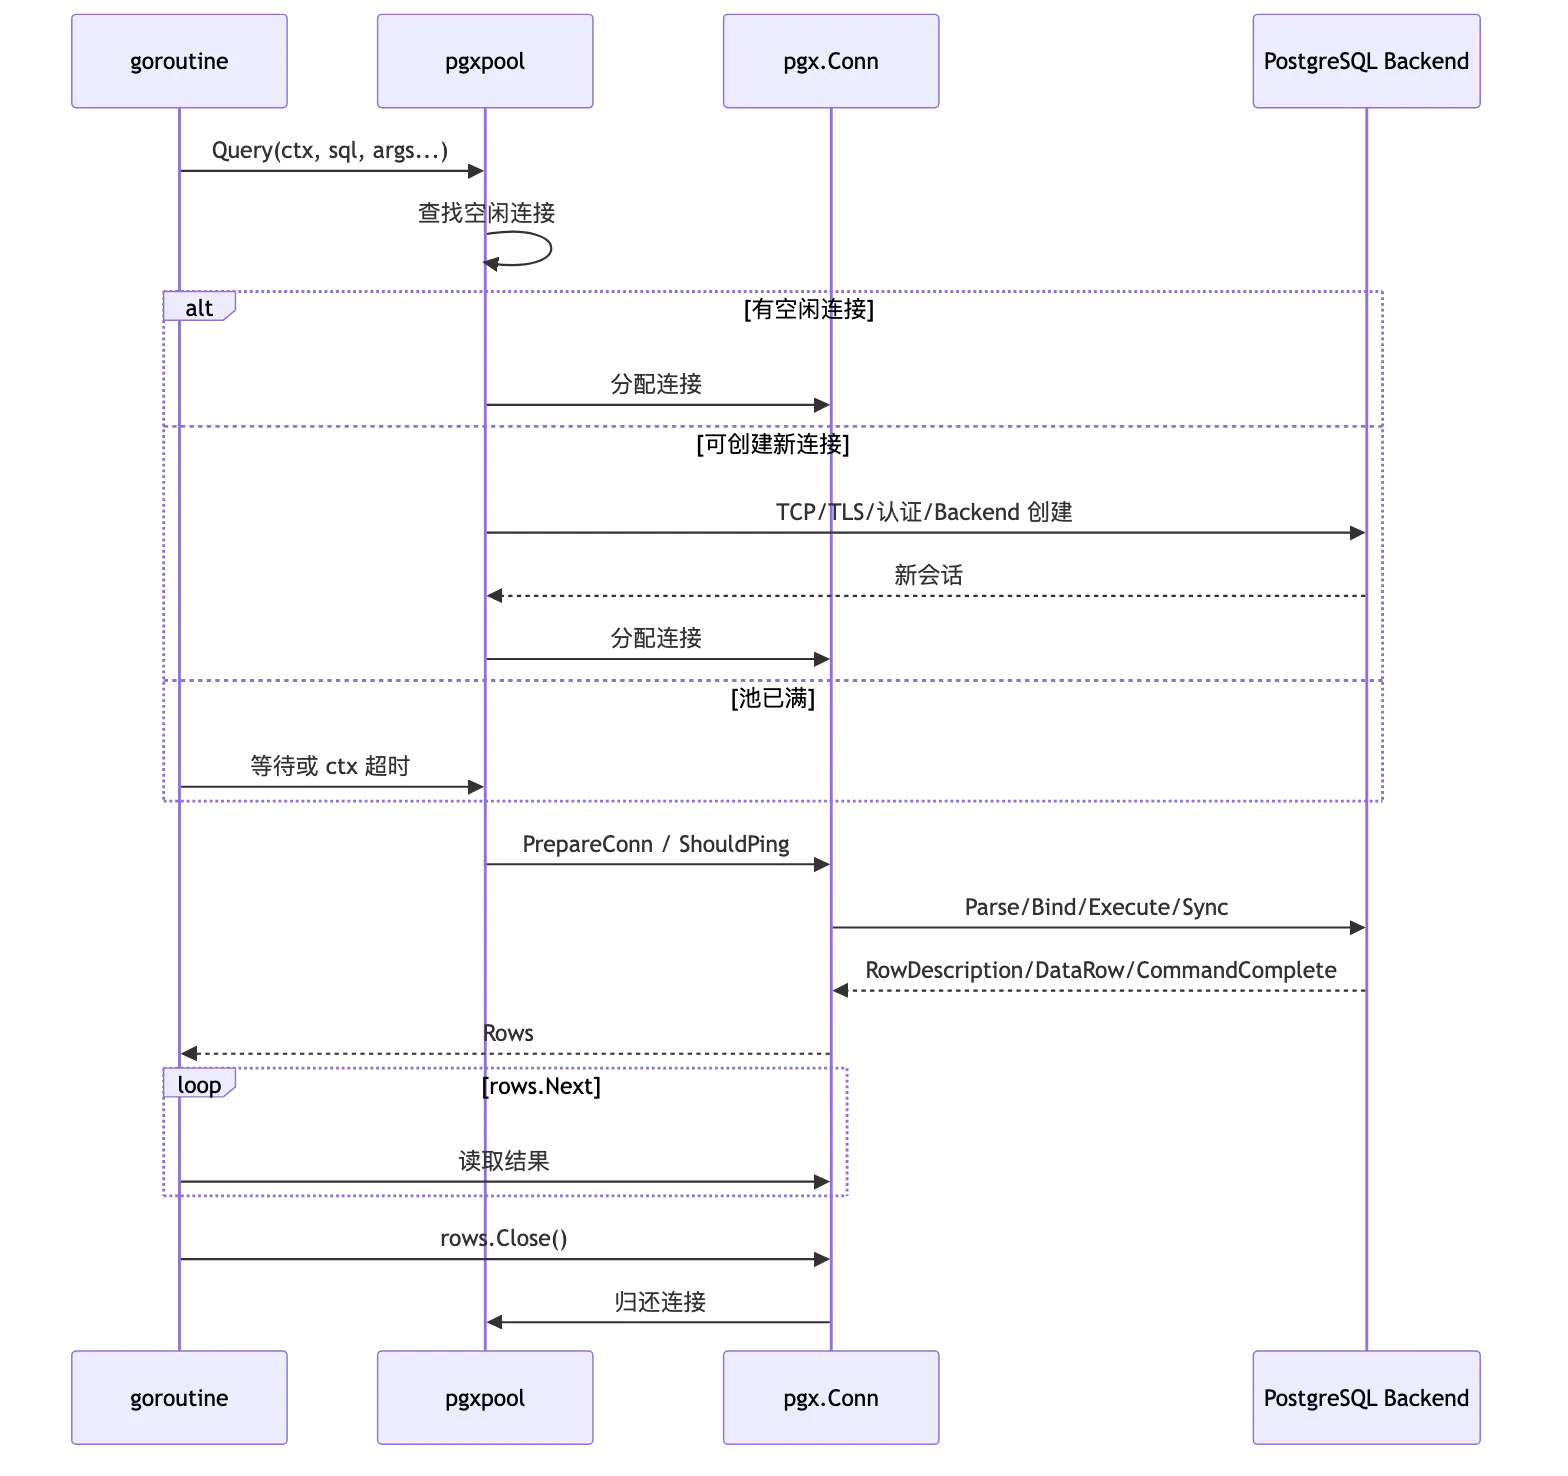
Pool.Query 在返回 Rows 后仍占用连接,直到结果读完或 Rows.Close();QueryRow 则在调用 Scan() 时释放连接。忘记 Scan、Close 或 rows.Err() 都可能造成资源泄漏或错误丢失。(Go Packages)
4.3 加入 PgBouncer 后
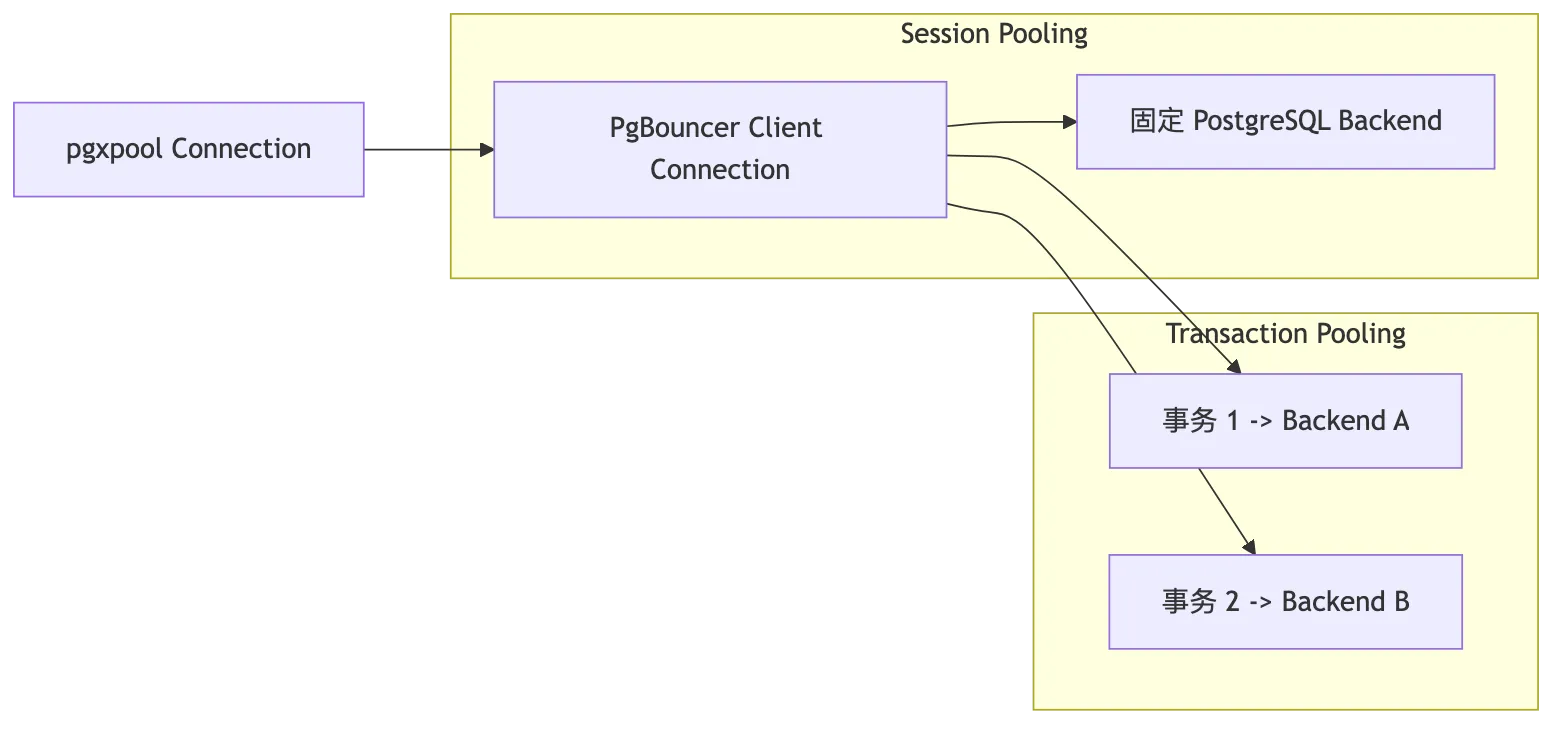
在 Transaction Pooling 中:
- pgx 看到的“连接”只固定到 PgBouncer;
- 不保证下一个事务仍使用同一个 PostgreSQL Backend;
- 会话级
SET、持久临时表、LISTEN和 Session Advisory Lock 不可依赖; - 事务内的
SET LOCAL、普通事务锁和事务级数据操作仍有明确边界; - Prepared Statement 是否可用取决于 PgBouncer 版本和
max_prepared_statements配置。(PgBouncer)
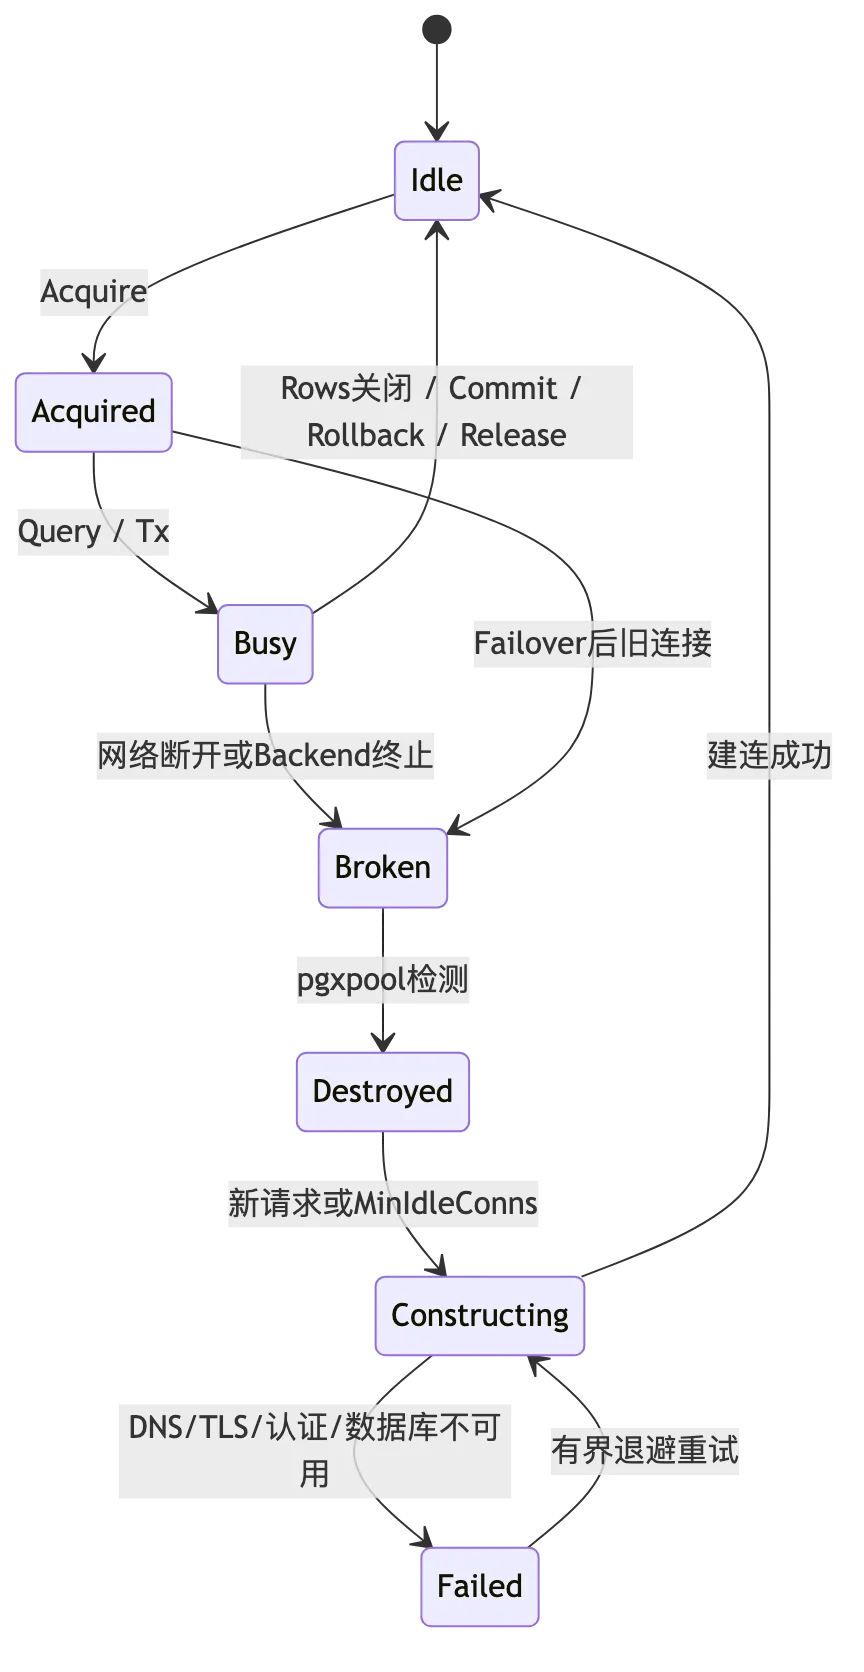
4.4 故障路径
5. 使用方式
5.1 pgx 原生接口与 database/sql
| 方案 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
pgx 原生接口 | PostgreSQL 专用服务 | 类型系统、COPY、Batch、通知、协议模式和错误信息更直接 | 与 database/sql 生态接口不同 |
pgxpool | 多 goroutine 生产服务 | 并发安全、统计完整、与 pgx API 接近 | 需要自行设计连接预算 |
pgx/stdlib | 第三方库要求 database/sql | 兼容 sql.DB 生态 | PostgreSQL 专属能力暴露较弱 |
原生 database/sql 抽象 | 同一代码需要支持多个数据库驱动 | 通用接口 | 容易牺牲 PG 专属语义,且 sql.DB 本身也是池 |
单个 pgx.Conn | CLI、迁移工具、专有会话、LISTEN Worker | 会话边界明确 | 不能被多个 goroutine 并发使用 |
不要同时无预算地创建:
- 一个大型
pgxpool.Pool; - 一个独立的
sql.DB池; - 一个后台任务池;
- 一个读副本池。
它们最终都消耗 PostgreSQL 或 PgBouncer 的连接预算。
5.2 核心对象的资源边界
| 对象 | 获得资源 | 释放方式 | 常见泄漏 |
|---|---|---|---|
pgxpool.Pool | 多个物理连接 | Pool.Close() | 应用退出未关闭 |
pgxpool.Conn | 一个池连接租约 | Release() | Acquire 后提前返回 |
pgx.Tx | 一个连接和事务 | Commit() 或 Rollback() | 错误路径未回滚 |
pgx.Rows | 查询结果流和连接 | 读尽或 Close() | 循环提前退出 |
pgx.BatchResults | 批次结果和连接协议状态 | Close() | 只读取部分结果 |
| Pipeline | 连接的 Pipeline 状态 | Close() | 错误后未恢复正常模式 |
BatchResults.Close() 不只是“释放内存”。它还负责消费剩余结果并使连接恢复到可复用状态;若协议状态无法确定,底层连接可能被关闭。Rows 同样必须关闭,并在循环后检查 rows.Err()。
5.3 当前 pgxpool.Config 的关键字段
| 字段 | 作用 | 生产注意事项 |
|---|---|---|
MaxConns | 单实例池上限 | 由全局连接预算和压测共同决定 |
MinConns | 池中的最少总连接数 | 不等于始终存在可立即使用的空闲连接 |
MinIdleConns | 维持的最少空闲连接数 | 对降低突发请求建连尾延迟更直接 |
MaxConnLifetime | 连接最大寿命 | 用于轮换连接,不应用于掩盖泄漏 |
MaxConnLifetimeJitter | 在寿命上增加随机抖动 | 防止同一时刻批量重建连接 |
MaxConnIdleTime | 空闲连接最长保留时间 | 太短会产生连接抖动 |
HealthCheckPeriod | 空闲连接健康维护周期 | 不是业务请求健康检查周期 |
PingTimeout | 池内部 Ping 最大等待时间 | 避免健康检查无限卡住 |
AfterConnect | 新物理连接建成后初始化 | 只做快速、确定、幂等操作 |
PrepareConn | 每次借出前验证或准备连接 | 会影响每次 Acquire;避免无条件执行昂贵 SQL |
ShouldPing | 决定 Acquire 时是否 Ping | 默认会检查长时间空闲的连接 |
BeforeClose | 连接关闭前回调 | 只能做轻量清理或观测 |
当前文档明确说明:MinIdleConns 更适合维持可立即使用的空闲容量;PrepareConn 已取代旧的 BeforeAcquire;ShouldPing 默认会 Ping 空闲至少约一秒的连接。(Go Packages)
5.4 Acquire 与 AcquireFunc
conn, err := pool.Acquire(ctx)
if err != nil {
	return err
}
defer conn.Release()

var now time.Time
err = conn.QueryRow(ctx, `SELECT clock_timestamp()`).Scan(&now)
适合必须连续操作同一会话的场景。
err := pool.AcquireFunc(ctx, func(conn *pgxpool.Conn) error {
	_, err := conn.Exec(ctx, `SELECT pg_advisory_xact_lock($1)`, lockID)
	return err
})
AcquireFunc 自动释放连接,但传给 AcquireFunc 的 ctx 只约束获取连接,不会自动为回调函数创建新的执行期限。业务 SQL 仍应使用带 deadline 的上下文。
不需要会话独占时,优先直接使用:
_, err := pool.Exec(ctx, sql, args...)
rows, err := pool.Query(ctx, sql, args...)
err := pool.QueryRow(ctx, sql, args...).Scan(&value)
5.5 Simple 与 Extended Protocol
| pgx 模式 | 协议与行为 | 优点 | 风险与适用边界 |
|---|---|---|---|
QueryExecModeCacheStatement | Extended;自动缓存协议级 Prepared Statement | 重复查询往返少,默认首选 | Schema 或 search_path 改变后首个执行可能遇到缓存失效问题 |
QueryExecModeCacheDescribe | Extended;缓存类型描述 | 不依赖长期命名计划 | 仍有描述失效边界 |
QueryExecModeDescribeExec | Extended;先 Describe 后 Execute | 更能适应并发 Schema 变化 | 通常需要额外往返;后端切换型代理可能在两轮之间换连接 |
QueryExecModeExec | Extended;文本参数与结果 | 一次往返,较适合严格 Pooler 兼容 | 对未知或歧义类型需显式转换 |
QueryExecModeSimpleProtocol | Simple;pgx 在客户端安全插值参数 | 某些不完整代理的最后兼容方案 | 功能和二进制编码受限,不应作为默认优化手段 |
即使使用 Simple Protocol,也必须继续使用 $1 参数调用 pgx API;不要自行拼接用户输入。
5.6 Session State
| 功能 | 直连/Session Pooling | Transaction Pooling |
|---|---|---|
| 普通事务 | 支持 | 支持 |
SET LOCAL | 支持 | 支持,作用限于事务 |
会话级 SET | 支持 | 不可靠 |
临时表 ON COMMIT DROP | 支持 | 通常可用,但需严格限制事务边界 |
| 持久临时表 | 支持 | 不可靠 |
LISTEN | 支持 | 不支持 |
| Session Advisory Lock | 支持 | 不支持 |
| Transaction Advisory Lock | 支持 | 支持 |
| 协议级 Prepared Statement | 支持 | 依赖 PgBouncer 配置 |
SQL PREPARE | 支持 | 不支持 |
生产查询应尽量:
- 使用
app.orders之类的 Schema 限定名; - 不依赖请求之间保留的
search_path; - 不依赖“上一个请求执行过 SET”;
- 将事务级配置写成
SET LOCAL; - 为
LISTEN使用独立、固定的直连或 Session Pooling 连接。
5.7 TLS、application_name 与 search_path
DATABASE_URL 应由秘密管理系统提供,例如:
postgres://app_user:***@db.example.internal:5432/orders
?sslmode=verify-full
&sslrootcert=/run/secrets/ca.crt
&connect_timeout=5
生产注意事项:
- 安全边界需要主机名校验时采用
verify-full; application_name应包含服务、环境和角色,例如orders-api.prod.writer;- 不把租户、用户 ID 或高基数字段放进
application_name; - 避免使用包含不可信可写 Schema 的
search_path; - SQL 尽量使用 Schema 限定名;
- 不在日志中记录完整 DSN、密码、证书私钥或 SQL 参数。
6. 底层原理
6.1 Pool 建立并不等于数据库已可用
pgxpool.NewWithConfig 可以在尚未建立任何连接时返回,因此:
ParseConfig
  → 创建 Pool 对象
  → 返回成功
  → 第一次 Acquire/Ping
  → DNS
  → TCP
  → TLS
  → Authentication
  → PostgreSQL Backend 创建
  → AfterConnect
  → 可用
启动时必须至少执行一次有期限的 Ping 或 Acquire,否则可能出现:
- 服务进程启动成功;
- readiness 提前变绿;
- 第一批真实请求才发现 DNS、证书、密码或数据库不可用。
官方 pgxpool 文档也明确指出,创建池不会等待连接建立,应立即 Acquire 或 Ping 验证。(Go Packages)
6.2 Acquire 状态变化
Acquire(ctx)
  ├─ 有 IdleConn
  │    └─ PrepareConn / ShouldPing → 返回
  ├─ TotalConns < MaxConns
  │    └─ Constructing → AfterConnect → 返回
  └─ TotalConns == MaxConns
       └─ 进入等待队列
            ├─ 其他请求归还连接 → 成功
            └─ ctx 到期 → CanceledAcquireCount 增加
需要区分三段时间:
总请求时间
= 准入等待
+ Pool Acquire 等待
+ SQL/事务执行
+ 结果读取
+ 应用处理
只记录 SQL 执行耗时会漏掉连接池排队。
6.3 连接归还条件
以下操作会自动借出和归还连接:
Pool.Exec:函数返回时归还;Pool.QueryRow:调用Scan时归还;Pool.Query:Rows关闭或读尽时归还;Pool.BeginTx:Commit 或 Rollback 时归还;Pool.SendBatch:BatchResults.Close后归还。
因此下面的代码存在泄漏:
row := pool.QueryRow(ctx, sql, id)
// 忘记 row.Scan(...)
return nil
另一个常见问题:
rows, err := pool.Query(ctx, sql)
if err != nil {
	return err
}
defer rows.Close()

for rows.Next() {
	if shouldStop() {
		return nil // defer 会关闭,安全
	}
}
return nil // 仍遗漏 rows.Err()
正确结尾:
if err := rows.Err(); err != nil {
	return err
}
6.4 事务 Context 边界
BeginTx(ctx, ...) 的 ctx 主要约束开始事务命令,不表示之后一旦 ctx 取消,pgx 会自动替你回滚整个事务。因此仍必须明确:
tx, err := pool.BeginTx(ctx, opts)
if err != nil {
	return err
}

defer func() {
	rollbackCtx, cancel := context.WithTimeout(
		context.Background(),
		2*time.Second,
	)
	defer cancel()
	_ = tx.Rollback(rollbackCtx)
}()
事务中每条 SQL 继续使用受控 Context;成功路径单独检查 Commit。
6.5 Commit 结果不确定
时间线:
客户端发送 COMMIT
       ↓
服务端写入并刷出 Commit WAL
       ↓
服务端事务已提交
       ↓
网络断开 / Primary 故障 / 客户端超时
       ↓
客户端收到 error
此时客户端不能推断“事务未提交”。
因此:
- 不要看到 Commit 网络错误就直接重新创建订单;
- 使用 Idempotency Key;
- 重新查询业务唯一键或请求状态;
- 对外部副作用采用 Outbox;
- 将
08007 transaction_resolution_unknown和40003 statement_completion_unknown视为结果不确定,而不是普通可重试失败。PostgreSQL 官方建议应用依赖 SQLSTATE 而不是本地化错误文本。(PostgreSQL)
6.6 Pool.Reset() 与 Pool.Close()
Pool.Reset():
- 关闭当前池中的连接;
- 池本身保持可用;
- 已借出的连接在归还时关闭;
- 适合确认发生全局网络中断、服务器状态切换或路由变化后使用;
- 不应在每个单独查询错误上调用,否则会形成重连风暴。
Pool.Close():
- 用于应用停止;
- 会等待已借出连接归还;
- 没有
Close(ctx)形式; - 因此必须先停止接收新请求、取消 Worker、等待处理完成,再关闭池。(Go Packages)
7. 内部数据结构和状态
本章不涉及 Heap Page,但需要掌握以下状态。
7.1 应用侧状态
| 状态 | 含义 | 关键指标 |
|---|---|---|
| Idle | 已建立、未借出 | IdleConns |
| Acquired | 已借出 | AcquiredConns |
| Constructing | 正在 DNS/TCP/TLS/认证 | ConstructingConns |
| Waiting | 调用方等待可用连接 | Acquire 延迟、EmptyAcquireWaitTime |
| Canceled | 等待期间 Context 取消 | CanceledAcquireCount |
| Destroyed | 因空闲、寿命或错误关闭 | Destroy Count |
| Broken | 协议或网络状态不可复用 | 错误日志、新连接速率 |
7.2 PostgreSQL 侧状态
应用连接在 pg_stat_activity 中可能表现为:
state | 含义 | 池视角 |
|---|---|---|
active | 正在执行查询 | 通常已 Acquired |
idle | 会话空闲 | 可能是池中的 Idle,也可能已借出但应用未执行 SQL |
idle in transaction | 事务已开启但无当前 SQL | 高风险,连接和事务均未释放 |
idle in transaction (aborted) | 事务失败后未回滚 | 连接不能正常执行后续 SQL |
disabled | 统计跟踪关闭 | 不应据此判断业务状态 |
池中 AcquiredConns=20 不代表 PostgreSQL 有 20 条 active 查询:部分连接可能在应用代码、结果处理或慢外部调用中。
7.3 Pool.Stat() 指标
| 指标 | 解释 |
|---|---|
AcquireCount | 成功获取连接累计次数 |
AcquireDuration | 成功 Acquire 的累计耗时 |
AcquiredConns | 当前借出连接数 |
CanceledAcquireCount | 因 Context 取消而失败的 Acquire 累计次数 |
EmptyAcquireCount | 池为空后等待并最终成功的 Acquire 次数 |
EmptyAcquireWaitTime | 上述成功等待的累计耗时 |
ConstructingConns | 当前正在建立的连接数 |
IdleConns | 当前空闲连接数 |
NewConnsCount | 累计新建连接数 |
TotalConns | Constructing、Acquired 和 Idle 之和 |
这些是累计计数或快照。告警应计算时间窗口增量,而不是直接对累计值设阈值。(Go Packages)
8. 场景和选型决策
| 业务场景 | 推荐方案 | 不推荐方案 | 原因 | 性能代价 | 并发代价 | 一致性代价 | 高可用代价 | 运维复杂度 |
|---|---|---|---|---|---|---|---|---|
| 普通 Go API | 一个共享 pgxpool.Pool | 每请求创建连接或 Pool | 复用认证和 Backend | 少量池管理开销 | 有界排队 | 无直接代价 | 需处理旧连接 | 低 |
| PostgreSQL 专属服务 | 原生 pgx | 为抽象而强制 database/sql | 保留 COPY、Batch、协议与类型能力 | 较低 | 清晰 | 较清晰 | 错误信息完整 | 中 |
第三方库要求 sql.DB | pgx/stdlib | 自己重写第三方库 | 兼容生态 | 多一层抽象 | 需独立预算 | 取决于库 | 需核对重连 | 中 |
| 在线与后台任务并存 | 独立 Pool 或准入预算 | 共用一个满负载池 | 防止后台任务挤占请求 | 少量空闲连接 | 更稳定 | 无直接代价 | 多池重连需控制 | 中 |
| PgBouncer Transaction Pooling | 避免会话状态,核对 Prepared 配置 | LISTEN、Session Lock、持久临时表 | 后端不固定 | 多一跳 | 后端复用更高 | 会话语义变化 | 增加代理故障域 | 高 |
| LISTEN/NOTIFY Worker | 独立直连或 Session Pooling | 普通 Transaction Pool | LISTEN 绑定会话 | 占用固定连接 | 少一个池名额 | 通知本身非可靠队列 | 需重连并重新 LISTEN | 中 |
| 极高连接实例数 | PgBouncer + 小型应用池 | 每实例大 MinIdleConns | 降低 Backend 数量 | 代理开销 | 避免连接风暴 | 需遵守 Pooling 模式 | 多一层恢复逻辑 | 高 |
| Failover 写入口 | 独立 Writer Pool + 可写验证 | 读写共用模糊地址 | 避免写到只读节点 | 健康验证成本 | 重建期间排队 | 可减少错误路由 | 仍需幂等与退避 | 高 |
9. 高性能分析
9.1 连接池大小推导
先定义:
B_total   = PostgreSQL max_connections
B_reserve = 超级用户、保留角色、复制、监控、迁移、应急连接
B_other   = 其他服务与工具的预算
B_app     = B_total - B_reserve - B_other
N_peak    = 发布、扩容、故障转移期间可能同时存在的应用实例数
B_inst    = floor(B_app / N_peak)
C_knee    = 压测中吞吐停止增长或P99明显恶化前的活跃查询并发
每实例初始上限:
MaxConns <= min(B_inst, C_knee)不能仅使用:
MaxConns = CPU 核数 × 固定倍数因为最终值还取决于:
- 数据规模和行宽;
- 查询 CPU/I/O 特征;
- P95/P99 查询时长;
- 事务锁持有时间;
- 读写比例;
- WAL 和存储延迟;
- Primary 与 Replica 数量;
- 发布时双倍实例;
- Failover 后重连;
- 运维保留连接。
PostgreSQL 会按 max_connections 分配部分资源,包括共享内存;简单提高数据库上限并非无成本。(PostgreSQL)
9.2 推导示例
假设,仅作为方法示例:
max_connections                      300
超级用户、保留角色和应急              20
复制、监控、迁移                      20
其他服务                              60
本服务总预算                         200

正常实例数                              8
滚动发布/故障峰值实例数                 12
按连接预算每实例 floor(200/12)          16

压测发现:
活跃查询从 12 增至 16 时吞吐基本不变,
但数据库 CPU Run Queue 和 P99 明显上升。

因此初始 MaxConns = 12,而不是 16。
这 12 个连接还应按工作负载拆分,例如:
前台写请求池:8
前台只读池:2
后台任务池:2
是否拆为三个物理 Pool,要综合最低连接数和运维复杂度;也可以一个 Pool 配三个应用层 Semaphore。
9.3 性能成本
CPU
连接过多会增加:
- Backend Process 调度;
- 上下文切换;
- Planner/Executor 并发;
- 锁管理竞争;
- 缓存失效。
内存
每条连接可能持有:
- Backend 私有内存;
- Prepared Statement 与 Portal 状态;
- Sort/Hash 工作内存;
- 客户端缓冲区;
- TLS 状态。
work_mem 是每个执行节点潜在消耗,不应以“连接数 × work_mem”简单等同实际使用,但连接和并行节点越多,峰值越危险。
shared_buffers 与 OS Page Cache
连接池大小不会改变 shared_buffers 容量。增加连接可能让更多互不相关的查询并发执行,造成:
- Buffer 缓存稀释;
- 随机 I/O 增加;
- Page Cache 抖动。
随机和顺序 I/O
连接数过少可能无法利用存储并发;连接数过多则会提高 Queue Depth 和尾延迟。最佳点必须通过稳定态压测确认。
[PG18] AIO
PostgreSQL 18 AIO 可以改善部分数据 I/O 路径,但它不会消除:
- CPU 上限;
- 锁竞争;
- WAL Flush;
- Backend 调度;
- Pool 排队;
- 应用的网络往返。
因此不能因为启用 AIO 就成倍放大 MaxConns。
网络往返
- 单行高频请求受 RTT 影响明显;
- Statement Cache、Batch 和 Pipeline 可减少往返;
- 但 Batch/Pipeline 会增加错误处理和连接占用复杂度;
- 大结果集长时间流式读取也会长期占用连接。
WAL、Checkpoint 和 Vacuum
连接池不直接生成 WAL,但更高写并发会影响:
- WAL Insert/Flush 竞争;
- Checkpoint 脏页;
- Dead Tuple 生成;
- Autovacuum 追赶速度;
- 副本重放延迟。
P95/P99
平均 Acquire 时间可能正常,但少量长事务可让 P99 Acquire 激增。因此至少记录:
- 请求总延迟;
- Acquire 延迟 Histogram;
- SQL 延迟;
- 事务时长;
- 结果读取时长;
AcquiredConns/MaxConns;CanceledAcquireCount增量。
9.4 Pool 指标推导
时间窗口内:
池使用率 ≈ AcquiredConns / MaxConns

等待成功比例
= ΔEmptyAcquireCount / ΔAcquireCount

成功等待平均值
= ΔEmptyAcquireWaitTime / ΔEmptyAcquireCount

Acquire 取消率
= ΔCanceledAcquireCount / 请求数

连接抖动率
= ΔNewConnsCount / 时间
AcquireDuration/AcquireCount 只能得到累计平均,不能替代 P95/P99。生产中应在调用边界单独记录 Histogram。
10. 高并发分析
10.1 五个不能混淆的数字
| 指标 | 含义 |
|---|---|
| goroutine 数 | 应用并发执行单元,可以远大于连接数 |
| 连接数 | 到数据库或 PgBouncer 的物理会话数 |
| 活跃查询数 | 当前正在 PostgreSQL 执行 SQL 的 Backend 数 |
| TPS | 每秒成功完成的事务数 |
| 排队请求数 | 等待准入、等待 Pool 或等待锁的请求数 |
例如:
2000 个 goroutine
→ 200 个通过应用准入
→ 20 个取得连接
→ 12 个正在执行 SQL
→ 8 个在应用处理结果或事务间隙
→ 180 个等待 Pool
→ 1800 个等待准入或已被拒绝
这不等于 2000 个数据库并发。
10.2 goroutine 与连接的关系
错误模式:
for _, item := range items {
	go func() {
		_, _ = pool.Exec(ctx, sql, item.ID)
	}()
}
即使 Pool 限制了数据库连接,也会创建无限等待 goroutine,导致:
- 堆内存增长;
- 调度开销;
- Context 和请求对象长期存活;
- 下游恢复后瞬时冲击;
- 超时和重试风暴。
正确方向:
sem := make(chan struct{}, concurrency)

for _, item := range items {
	select {
	case sem <- struct{}{}:
	case <-ctx.Done():
		return ctx.Err()
	}

	go func(item Item) {
		defer func() { <-sem }()
		process(ctx, item)
	}(item)
}
还需使用 WaitGroup、错误收集和总任务取消。
10.3 长事务为什么耗尽池
BeginTx
→ UPDATE,持有行锁
→ 调用外部支付接口 5 秒
→ 再执行 SQL
→ Commit
这五秒内:
- 连接不能归还;
- 行锁不能释放;
- Snapshot 可能继续存在;
- 其他事务可能排队;
- Pool 的可用连接减少;
- 请求超时后可能触发重试。
应改为:
事务前:调用无需依赖数据库锁的外部服务
事务内:只执行必要数据库操作
事务后:通过 Outbox 驱动外部副作用
不能简单把所有外部调用移到事务前;必须重新分析业务原子性,必要时使用预授权、状态机或 Outbox。
10.4 热点和锁竞争
增加 Pool 连接数不能解决:
- 单库存行更新;
- 单账户余额行;
- 单租户序列化锁;
- 热门唯一键 Upsert;
- 固定队列表头;
- 同一 B-tree 右侧热点。
反而可能使更多 Backend 同时排队于同一锁,形成 Lock Convoy。
10.5 重试风暴
事务重试必须:
- 仅重试明确可重试的
40001和40P01; - 重试完整事务;
- 有最大次数;
- 指数退避和随机抖动;
- 受 Context 总预算约束;
- 通过全局并发限制防止恢复后洪峰;
- 不把 Commit 结果不确定当作普通事务冲突。
11. 高可用分析
本章与高可用的关系是间接但关键:连接池不决定 RPO,却直接影响故障发生后的应用 RTO 和恢复稳定性。
11.1 Failover 时发生什么
Primary A
  ↓ TCP连接
pgxpool 中已有连接

A 故障
  ↓
Replica B Promote
  ↓
VIP/DNS/代理切到 B
现有 TCP 连接不会迁移到 B:
- 正在执行的请求可能收到 EOF、Connection Reset、Admin Shutdown;
- 空闲旧连接可能直到下一次使用才被发现失效;
- 新 Acquire 会尝试建立新连接;
- Session State、Prepared Statement、临时表和 LISTEN 状态会丢失;
- 所有应用实例可能同时重连。
11.2 RPO 和 RTO
| 项目 | pgxpool 的作用 |
|---|---|
| RPO | 不决定复制是否丢数据 |
| 数据库 Failover RTO | 不决定 Promotion 速度 |
| 应用恢复 RTO | 决定旧连接清除、重连、退避和 readiness 恢复方式 |
| 脑裂 | 不能代替 Fencing |
| 提交结果不确定 | 必须由业务幂等和对账解决 |
| 读写路由 | 应由 Writer/Reader Endpoint 和 Pool 隔离 |
| Failback | Pool 仍需逐步重建连接 |
11.3 Connection Storm
危险配置:
100 个应用实例
每实例 MinIdleConns = 20
Failover 后理论重连目标 = 2000 个连接
即使数据库最终只允许 300 条连接,也可能先遭遇:
- TLS 握手 CPU 峰值;
- 认证压力;
- Backend Fork/启动压力;
- DNS 和代理排队;
53300 too_many_connections;- readiness 抖动;
- 所有实例同步重试。
缓解:
MaxConnLifetimeJitter;- 启动和重连随机抖动;
- 小型
MinIdleConns; - 有界实例启动;
- PgBouncer;
- 应用层 Circuit Breaker 和 Load Shedding;
- 为运维保留连接槽位;
- 不在每个错误上调用
Reset()。
11.4 Readiness 与 Liveness
Liveness
只表示进程事件循环仍健康,不应因为数据库暂时不可用就让编排器无限重启应用。
Readiness
表示实例是否适合接收需要数据库的流量。检查应:
- 有短期限;
- 低频或后台缓存结果;
- 使用真实权限;
- 不执行重查询;
- Failover 时及时转为不可用;
- 恢复时避免所有实例同时高频 Ping。
11.5 SQLSTATE
生产分类至少识别:
| SQLSTATE | 含义 | 建议 |
|---|---|---|
40001 | Serialization Failure | 可重试完整事务 |
40P01 | Deadlock Detected | 可重试完整事务 |
23505 | Unique Violation | 通常为业务冲突,不自动重试 |
25006 | Read-only SQL Transaction | 可能路由到了只读节点 |
53300 | Too Many Connections | 背压、降载、检查连接预算 |
57014 | Query Canceled | 区分 Context、statement_timeout 和人工取消 |
57P01 | Admin Shutdown | 重连,常见于 Failover/维护 |
57P02 | Crash Shutdown | 等待数据库恢复 |
57P03 | Cannot Connect Now | 数据库恢复或 Promotion 期间 |
08007 | Transaction Resolution Unknown | 对账,不能盲重试 |
40003 | Statement Completion Unknown | 对账,不能盲重试 |
这些代码及其稳定分类来自 PostgreSQL 官方 SQLSTATE 表。(PostgreSQL)
12. 三维影响矩阵
| 维度 | 相关度 | 核心收益 | 主要风险 | 关键指标 |
|---|---|---|---|---|
| 高性能 | 高 | 复用连接、减少握手、限制数据库并发、降低尾延迟 | 池过大、连接抖动、长结果占池 | Acquire P95/P99、NewConns、SQL P99 |
| 高并发 | 高 | goroutine 与数据库并发解耦、提供排队和背压 | Pool 耗尽、无限 goroutine、长事务、重试风暴 | Acquired/Max、Empty Wait、Canceled Acquire |
| 高可用 | 中 | 自动剔除旧连接、故障后重建、支持健康检查 | Connection Storm、旧连接、Commit 不确定 | 重连率、SQLSTATE、readiness、恢复时间 |
13. 实验
实验一:限制 MaxConns 并复现连接池耗尽
13.1 实验目标
验证:
- goroutine 数不等于数据库连接数;
- Pool 满时请求在客户端等待;
- 等待 Acquire 的请求不会出现在 PostgreSQL 的
pg_stat_activity中; - Context 可以取消 Acquire;
EmptyAcquireCount与CanceledAcquireCount含义不同。
13.2 环境
- PostgreSQL 14~18;
- 当前 pgx/v5;
- 不需要扩展;
- 仅在测试环境执行。
13.3 准备
CREATE SCHEMA IF NOT EXISTS lab16;

CREATE TABLE IF NOT EXISTS lab16.pool_test (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    note text NOT NULL,
    created_at timestamptz NOT NULL DEFAULT clock_timestamp()
);
连接池配置:
cfg.MaxConns = 2
cfg.MinConns = 0
cfg.MinIdleConns = 0
13.4 Session A 与 B
两个 goroutine 各自执行:
SELECT pg_backend_pid(), pg_sleep(8);时间线:
T0:A 获取连接 1,开始 pg_sleep
T0:B 获取连接 2,开始 pg_sleep
T1:Pool AcquiredConns = 2
13.5 Session C:等待后成功
C 使用 15 秒 Context:
ctx, cancel := context.WithTimeout(context.Background(), 15*time.Second)
defer cancel()

var one int
err := pool.QueryRow(ctx, `SELECT 1`).Scan(&one)
C 会在 Pool 等待,直到 A 或 B 归还连接。预期:
EmptyAcquireCount增加;EmptyAcquireWaitTime增加;- PostgreSQL 在 C 获得连接前看不到第三条查询。
13.6 Session C:等待后取消
重新启动 A、B,然后将 C 的 Context 改为一秒:
ctx, cancel := context.WithTimeout(context.Background(), time.Second)
defer cancel()

err := pool.QueryRow(ctx, `SELECT 1`).Scan(&one)
预期:
- C 在客户端失败;
CanceledAcquireCount增加;- 数据库没有执行
SELECT 1; - 这不是 PostgreSQL
statement_timeout。
13.7 诊断 SQL
SELECT
    pid,
    application_name,
    state,
    wait_event_type,
    wait_event,
    query_start,
    state_change,
    left(query, 120) AS query
FROM pg_stat_activity
WHERE datname = current_database()
ORDER BY backend_start;
重要字段:
application_name:映射服务;state:Backend 当前状态;wait_event_type/wait_event:数据库内等待;query_start:当前或最近查询开始时间;state_change:状态变化时间。
连接池等待不属于 PostgreSQL Wait Event,因此必须结合应用指标。
13.8 记录指标
禁止伪造固定性能结果。记录:
- PostgreSQL 版本;
MaxConns;- 并发 goroutine 数;
- 每个请求的 Acquire P50/P95/P99;
AcquiredConns;EmptyAcquireCount;EmptyAcquireWaitTime;CanceledAcquireCount;- PostgreSQL Backend 数;
- CPU 和网络。
13.9 清理
DROP SCHEMA lab16 CASCADE;13.10 生产警告
不要在生产实例使用大量 pg_sleep 占满全部连接。
实验二:事务中调用慢外部服务
13.11 实验目标
比较:
- 事务内等待外部服务;
- 外部调用移到事务外;
- 连接占用和行锁等待的变化。
13.12 准备
CREATE SCHEMA IF NOT EXISTS lab16;

CREATE TABLE lab16.accounts (
    id bigint PRIMARY KEY,
    balance_cents bigint NOT NULL CHECK (balance_cents >= 0)
);

INSERT INTO lab16.accounts(id, balance_cents)
VALUES (1, 100000)
ON CONFLICT (id) DO UPDATE
SET balance_cents = EXCLUDED.balance_cents;
13.13 Session A:错误模式
T0  BeginTx
T1  UPDATE accounts SET balance_cents = balance_cents - 100 WHERE id = 1
T2  在 Go 中 time.Sleep(10s),模拟慢外部服务
T12 Commit
Session A 的 SQL:
UPDATE lab16.accounts
SET balance_cents = balance_cents - 100
WHERE id = 1;
13.14 Session B
在 T2 执行:
UPDATE lab16.accounts
SET balance_cents = balance_cents + 50
WHERE id = 1;
B 会等待 A 结束。
13.15 Session C:诊断
SELECT
    a.pid,
    a.application_name,
    a.state,
    a.xact_start,
    clock_timestamp() - a.xact_start AS xact_age,
    a.wait_event_type,
    a.wait_event,
    pg_blocking_pids(a.pid) AS blockers,
    left(a.query, 120) AS query
FROM pg_stat_activity AS a
WHERE a.datname = current_database()
ORDER BY a.xact_start NULLS LAST;
预期:
- A 可能显示
idle in transaction; - A 仍占用 pgxpool 连接;
- B 等待事务 ID 或行锁;
- Pool 可用连接减少。
13.16 改进模式
T0  在事务外完成可安全前置的外部调用
T10 BeginTx
T11 UPDATE
T12 Commit
再次测量:
- 事务时长;
AcquiredConns;- B 的锁等待;
- 请求 P95/P99;
- Pool Acquire 延迟。
13.17 注意
外部调用不能机械地移到事务外。必须分析:
- 调用是否可撤销;
- 是否需要预授权;
- 是否会重复;
- 是否应采用 Outbox 或 Saga;
- Commit 不确定时如何对账。
实验三:数据库重启或 Failover 后的连接池恢复
13.18 实验目标
观察:
- 旧 TCP 连接不会迁移;
- 空闲旧连接可能在再次使用时才暴露错误;
- Pool 如何销毁旧连接并建立新连接;
NewConnsCount和错误分类如何变化。
13.19 环境
仅使用可丢弃测试环境,任选:
- 重启 PostgreSQL;
- Patroni 测试集群执行 Switchover;
- 切换测试代理上游;
- 不要在未演练的生产系统直接操作。
13.20 Session A
每秒执行:
SELECT
    pg_backend_pid(),
    pg_is_in_recovery(),
    clock_timestamp();
同时记录:
- Backend PID;
- 错误;
- SQLSTATE;
Pool.Stat();- readiness 状态。
13.21 Session B
在 T5 重启数据库或执行 Planned Switchover。
13.22 Session C
观察数据库恢复后:
SELECT
    application_name,
    backend_start,
    state,
    count(*)
FROM pg_stat_activity
GROUP BY application_name, backend_start, state
ORDER BY backend_start;
13.23 预期结果
- 某些在途请求失败;
- 已提交但客户端未收到响应的写事务可能结果不确定;
- 旧 PID 消失,新连接得到新 PID;
NewConnsCount增长;- 恢复时间取决于数据库、代理、DNS、Context 和重试退避;
- 不应声称所有请求都会由 pgx 自动无损重试。
13.24 Reset() 对照
确认路由已切换后,可测试一次:
pool.Reset()比较自然淘汰与主动 Reset 的恢复速度和连接风暴。禁止在每个错误上调用。
14. 完整 Go 示例
14.1 示例 Schema
CREATE SCHEMA IF NOT EXISTS app;

CREATE TABLE app.users (
    tenant_id bigint NOT NULL,
    id bigint NOT NULL,
    email text NOT NULL,
    created_at timestamptz NOT NULL DEFAULT clock_timestamp(),
    PRIMARY KEY (tenant_id, id),
    UNIQUE (tenant_id, email)
);

CREATE TABLE app.accounts (
    tenant_id bigint NOT NULL,
    id bigint NOT NULL,
    balance_cents bigint NOT NULL CHECK (balance_cents >= 0),
    PRIMARY KEY (tenant_id, id)
);

CREATE TABLE app.audit_events (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tenant_id bigint NOT NULL,
    event_type text NOT NULL,
    payload jsonb NOT NULL,
    created_at timestamptz NOT NULL DEFAULT clock_timestamp()
);
14.2 生产级骨架
package main

import (
	"context"
	"errors"
	"fmt"
	"log/slog"
	"net/http"
	"os"
	"os/signal"
	"strconv"
	"sync"
	"sync/atomic"
	"syscall"
	"time"

	"github.com/jackc/pgx/v5"
	"github.com/jackc/pgx/v5/pgconn"
	"github.com/jackc/pgx/v5/pgxpool"
)

type queryNameKey struct{}
type traceStateKey struct{}

type traceState struct {
	name    string
	started time.Time
}

func withQueryName(ctx context.Context, name string) context.Context {
	return context.WithValue(ctx, queryNameKey{}, name)
}

type dbTracer struct {
	log *slog.Logger
}

func (t *dbTracer) TraceQueryStart(
	ctx context.Context,
	_ *pgx.Conn,
	_ pgx.TraceQueryStartData,
) context.Context {
	name, _ := ctx.Value(queryNameKey{}).(string)
	if name == "" {
		name = "unnamed"
	}

	return context.WithValue(ctx, traceStateKey{}, traceState{
		name:    name,
		started: time.Now(),
	})
}

func (t *dbTracer) TraceQueryEnd(
	ctx context.Context,
	_ *pgx.Conn,
	data pgx.TraceQueryEndData,
) {
	state, _ := ctx.Value(traceStateKey{}).(traceState)

	attrs := []any{
		"query_name", state.name,
		"duration", time.Since(state.started),
		"command_tag", data.CommandTag.String(),
		// 对 INSERT/UPDATE/DELETE 有意义;
		// 不能解释为 SELECT 被应用消费的结果行数。
		"rows_affected", data.CommandTag.RowsAffected(),
	}

	if data.Err == nil {
		t.log.Info("database query completed", attrs...)
		return
	}

	attrs = append(attrs, "error_class", classifyDBError(data.Err))

	var pgErr *pgconn.PgError
	if errors.As(data.Err, &pgErr) {
		attrs = append(attrs,
			"sqlstate", pgErr.Code,
			"constraint", pgErr.ConstraintName,
			"table", pgErr.TableName,
		)
	}

	// 不记录 SQL 参数,避免凭据、PII 和业务数据泄漏。
	t.log.Error("database query failed",
		append(attrs, "error", data.Err)...,
	)
}

func classifyDBError(err error) string {
	if err == nil {
		return "none"
	}
	if errors.Is(err, context.Canceled) {
		return "context_canceled"
	}
	if errors.Is(err, context.DeadlineExceeded) {
		return "context_deadline"
	}

	var pgErr *pgconn.PgError
	if !errors.As(err, &pgErr) {
		return "network_or_client"
	}

	switch pgErr.Code {
	case "40001", "40P01":
		return "retryable_transaction"
	case "08007", "40003":
		return "outcome_unknown"
	case "23505":
		return "unique_violation"
	case "23503":
		return "foreign_key_violation"
	case "23514":
		return "check_violation"
	case "25006":
		return "read_only_route"
	case "53300":
		return "too_many_connections"
	case "55P03":
		return "lock_not_available"
	case "57014":
		return "query_canceled"
	case "57P01", "57P02", "57P03":
		return "server_unavailable"
	default:
		return "postgres_" + pgErr.Code[:2]
	}
}

func envInt32(name string, fallback int32) (int32, error) {
	value := os.Getenv(name)
	if value == "" {
		return fallback, nil
	}

	n, err := strconv.ParseInt(value, 10, 32)
	if err != nil || n < 0 {
		return 0, fmt.Errorf("%s must be a non-negative int32", name)
	}
	return int32(n), nil
}

func openPool(
	ctx context.Context,
	log *slog.Logger,
) (*pgxpool.Pool, error) {
	dsn := os.Getenv("DATABASE_URL")
	if dsn == "" {
		return nil, errors.New("DATABASE_URL is required")
	}

	cfg, err := pgxpool.ParseConfig(dsn)
	if err != nil {
		return nil, fmt.Errorf("parse DATABASE_URL: %w", err)
	}

	maxConns, err := envInt32("PGPOOL_MAX_CONNS", 12)
	if err != nil {
		return nil, err
	}
	minIdleConns, err := envInt32("PGPOOL_MIN_IDLE_CONNS", 2)
	if err != nil {
		return nil, err
	}
	if maxConns <= 0 {
		return nil, errors.New("PGPOOL_MAX_CONNS must be greater than zero")
	}
	if minIdleConns > maxConns {
		return nil, errors.New(
			"PGPOOL_MIN_IDLE_CONNS cannot exceed PGPOOL_MAX_CONNS",
		)
	}

	cfg.MaxConns = maxConns
	cfg.MinConns = 0
	cfg.MinIdleConns = minIdleConns
	cfg.MaxConnLifetime = 45 * time.Minute
	cfg.MaxConnLifetimeJitter = 5 * time.Minute
	cfg.MaxConnIdleTime = 10 * time.Minute
	cfg.HealthCheckPeriod = 30 * time.Second
	cfg.PingTimeout = 2 * time.Second

	cfg.ConnConfig.ConnectTimeout = 5 * time.Second
	cfg.ConnConfig.DefaultQueryExecMode = pgx.QueryExecModeCacheStatement

	if cfg.ConnConfig.RuntimeParams == nil {
		cfg.ConnConfig.RuntimeParams = make(map[string]string)
	}
	cfg.ConnConfig.RuntimeParams["application_name"] =
		"orders-api.prod.writer"

	cfg.ConnConfig.Tracer = &dbTracer{log: log}

	// 此示例假设直连 PostgreSQL 或使用 Session Pooling。
	// Transaction Pooling 下不要依赖请求之间保持该会话状态。
	cfg.AfterConnect = func(
		ctx context.Context,
		conn *pgx.Conn,
	) error {
		_, err := conn.Exec(ctx, `SET TIME ZONE 'UTC'`)
		return err
	}

	// 无额外网络往返地拒绝异常事务状态的连接。
	cfg.PrepareConn = func(
		_ context.Context,
		conn *pgx.Conn,
	) (bool, error) {
		return conn.PgConn().TxStatus() == 'I', nil
	}

	pool, err := pgxpool.NewWithConfig(ctx, cfg)
	if err != nil {
		return nil, fmt.Errorf("create pool: %w", err)
	}

	// NewWithConfig 成功不代表已建立连接。
	pingCtx, cancel := context.WithTimeout(ctx, 5*time.Second)
	defer cancel()

	if err := pool.Ping(pingCtx); err != nil {
		pool.Close()
		return nil, fmt.Errorf("initial database ping: %w", err)
	}

	warmCtx, warmCancel := context.WithTimeout(ctx, 10*time.Second)
	defer warmCancel()

	if err := warmPool(warmCtx, pool, minIdleConns); err != nil {
		pool.Close()
		return nil, fmt.Errorf("warm pool: %w", err)
	}

	return pool, nil
}

func warmPool(
	ctx context.Context,
	pool *pgxpool.Pool,
	count int32,
) error {
	conns := make([]*pgxpool.Conn, 0, count)
	defer func() {
		for i := len(conns) - 1; i >= 0; i-- {
			conns[i].Release()
		}
	}()

	for i := int32(0); i < count; i++ {
		conn, err := pool.Acquire(ctx)
		if err != nil {
			return err
		}
		conns = append(conns, conn)
	}
	return nil
}

type User struct {
	ID        int64
	Email     string
	CreatedAt time.Time
}

func getUser(
	ctx context.Context,
	pool *pgxpool.Pool,
	tenantID int64,
	userID int64,
) (User, error) {
	ctx = withQueryName(ctx, "user.get")

	var user User
	err := pool.QueryRow(ctx, `
		SELECT id, email, created_at
		FROM app.users
		WHERE tenant_id = $1
		  AND id = $2
	`, tenantID, userID).Scan(
		&user.ID,
		&user.Email,
		&user.CreatedAt,
	)
	if err != nil {
		return User{}, fmt.Errorf("get user: %w", err)
	}
	return user, nil
}

func listUsers(
	ctx context.Context,
	pool *pgxpool.Pool,
	tenantID int64,
	afterID int64,
	limit int32,
) ([]User, error) {
	ctx = withQueryName(ctx, "user.list")

	rows, err := pool.Query(ctx, `
		SELECT id, email, created_at
		FROM app.users
		WHERE tenant_id = $1
		  AND id > $2
		ORDER BY id
		LIMIT $3
	`, tenantID, afterID, limit)
	if err != nil {
		return nil, fmt.Errorf("query users: %w", err)
	}
	defer rows.Close()

	users := make([]User, 0, limit)
	for rows.Next() {
		var user User
		if err := rows.Scan(
			&user.ID,
			&user.Email,
			&user.CreatedAt,
		); err != nil {
			return nil, fmt.Errorf("scan user: %w", err)
		}
		users = append(users, user)
	}

	if err := rows.Err(); err != nil {
		return nil, fmt.Errorf("iterate users: %w", err)
	}
	return users, nil
}

var ErrInsufficientBalance = errors.New("insufficient balance")

func transfer(
	ctx context.Context,
	pool *pgxpool.Pool,
	tenantID int64,
	fromID int64,
	toID int64,
	amountCents int64,
) error {
	if amountCents <= 0 {
		return errors.New("amount must be positive")
	}
	if fromID == toID {
		return errors.New("source and destination must differ")
	}

	tx, err := pool.BeginTx(ctx, pgx.TxOptions{
		IsoLevel: pgx.Serializable,
	})
	if err != nil {
		return fmt.Errorf("begin transfer: %w", err)
	}

	// 使用独立、短时清理 Context,避免请求 Context 已取消后无法回滚。
	defer func() {
		rollbackCtx, cancel := context.WithTimeout(
			context.Background(),
			2*time.Second,
		)
		defer cancel()
		_ = tx.Rollback(rollbackCtx)
	}()

	lockCtx := withQueryName(ctx, "account.lock_transfer_pair")
	rows, err := tx.Query(lockCtx, `
		SELECT id, balance_cents
		FROM app.accounts
		WHERE tenant_id = $1
		  AND id = ANY($2::bigint[])
		ORDER BY id
		FOR UPDATE
	`, tenantID, []int64{fromID, toID})
	if err != nil {
		return fmt.Errorf("lock accounts: %w", err)
	}

	balances := make(map[int64]int64, 2)
	for rows.Next() {
		var id, balance int64
		if err := rows.Scan(&id, &balance); err != nil {
			rows.Close()
			return fmt.Errorf("scan locked account: %w", err)
		}
		balances[id] = balance
	}
	rows.Close()

	if err := rows.Err(); err != nil {
		return fmt.Errorf("iterate locked accounts: %w", err)
	}
	if len(balances) != 2 {
		return errors.New("account not found")
	}
	if balances[fromID] < amountCents {
		return ErrInsufficientBalance
	}

	updateCtx := withQueryName(ctx, "account.transfer_update")

	tag, err := tx.Exec(updateCtx, `
		UPDATE app.accounts
		SET balance_cents = balance_cents - $1
		WHERE tenant_id = $2
		  AND id = $3
	`, amountCents, tenantID, fromID)
	if err != nil {
		return fmt.Errorf("debit account: %w", err)
	}
	if tag.RowsAffected() != 1 {
		return errors.New("debit affected unexpected row count")
	}

	tag, err = tx.Exec(updateCtx, `
		UPDATE app.accounts
		SET balance_cents = balance_cents + $1
		WHERE tenant_id = $2
		  AND id = $3
	`, amountCents, tenantID, toID)
	if err != nil {
		return fmt.Errorf("credit account: %w", err)
	}
	if tag.RowsAffected() != 1 {
		return errors.New("credit affected unexpected row count")
	}

	if err := tx.Commit(ctx); err != nil {
		// 这里不能断言事务一定未提交。
		return fmt.Errorf(
			"commit transfer; outcome may be unknown: %w",
			err,
		)
	}
	return nil
}

type AuditEvent struct {
	TenantID int64
	Type     string
	Payload  []byte
}

func insertAuditBatch(
	ctx context.Context,
	pool *pgxpool.Pool,
	events []AuditEvent,
) (err error) {
	if len(events) == 0 {
		return nil
	}

	var batch pgx.Batch
	for _, event := range events {
		batch.Queue(`
			INSERT INTO app.audit_events(
			    tenant_id,
			    event_type,
			    payload
			)
			VALUES ($1, $2, $3::jsonb)
		`, event.TenantID, event.Type, event.Payload)
	}

	results := pool.SendBatch(
		withQueryName(ctx, "audit.insert_batch"),
		&batch,
	)

	defer func() {
		if closeErr := results.Close(); closeErr != nil {
			err = errors.Join(err, closeErr)
		}
	}()

	for range events {
		tag, execErr := results.Exec()
		if execErr != nil {
			return fmt.Errorf("execute audit batch: %w", execErr)
		}
		if tag.RowsAffected() != 1 {
			return errors.New("unexpected audit batch row count")
		}
	}
	return nil
}

func copyAuditEvents(
	ctx context.Context,
	pool *pgxpool.Pool,
	events []AuditEvent,
) (int64, error) {
	rows := make([][]any, 0, len(events))
	for _, event := range events {
		rows = append(rows, []any{
			event.TenantID,
			event.Type,
			event.Payload,
		})
	}

	count, err := pool.CopyFrom(
		withQueryName(ctx, "audit.copy_from"),
		pgx.Identifier{"app", "audit_events"},
		[]string{"tenant_id", "event_type", "payload"},
		pgx.CopyFromRows(rows),
	)
	if err != nil {
		return 0, fmt.Errorf("copy audit events: %w", err)
	}
	return count, nil
}

func healthLoop(
	ctx context.Context,
	pool *pgxpool.Pool,
	ready *atomic.Bool,
) {
	check := func() {
		pingCtx, cancel := context.WithTimeout(ctx, time.Second)
		err := pool.Ping(pingCtx)
		cancel()
		ready.Store(err == nil)
	}

	check()

	ticker := time.NewTicker(5 * time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ctx.Done():
			ready.Store(false)
			return
		case <-ticker.C:
			check()
		}
	}
}

func poolMetricsLoop(
	ctx context.Context,
	log *slog.Logger,
	pool *pgxpool.Pool,
) {
	ticker := time.NewTicker(10 * time.Second)
	defer ticker.Stop()

	for {
		select {
		case <-ctx.Done():
			return
		case <-ticker.C:
			stat := pool.Stat()
			log.Info("pgxpool stats",
				"max_conns", stat.MaxConns(),
				"total_conns", stat.TotalConns(),
				"acquired_conns", stat.AcquiredConns(),
				"idle_conns", stat.IdleConns(),
				"constructing_conns", stat.ConstructingConns(),
				"acquire_count", stat.AcquireCount(),
				"acquire_duration", stat.AcquireDuration(),
				"empty_acquire_count", stat.EmptyAcquireCount(),
				"empty_acquire_wait_time", stat.EmptyAcquireWaitTime(),
				"canceled_acquire_count", stat.CanceledAcquireCount(),
				"new_conns_count", stat.NewConnsCount(),
			)
		}
	}
}

func main() {
	log := slog.New(slog.NewJSONHandler(os.Stdout, nil))

	rootCtx, stop := signal.NotifyContext(
		context.Background(),
		syscall.SIGINT,
		syscall.SIGTERM,
	)
	defer stop()

	pool, err := openPool(rootCtx, log)
	if err != nil {
		log.Error("database startup failed", "error", err)
		os.Exit(1)
	}

	var ready atomic.Bool
	var wg sync.WaitGroup

	wg.Add(2)

	go func() {
		defer wg.Done()
		healthLoop(rootCtx, pool, &ready)
	}()

	go func() {
		defer wg.Done()
		poolMetricsLoop(rootCtx, log, pool)
	}()

	mux := http.NewServeMux()

	mux.HandleFunc("/livez", func(
		w http.ResponseWriter,
		_ *http.Request,
	) {
		w.WriteHeader(http.StatusOK)
		_, _ = w.Write([]byte("ok\n"))
	})

	mux.HandleFunc("/readyz", func(
		w http.ResponseWriter,
		_ *http.Request,
	) {
		if !ready.Load() {
			http.Error(
				w,
				"database not ready",
				http.StatusServiceUnavailable,
			)
			return
		}
		w.WriteHeader(http.StatusOK)
		_, _ = w.Write([]byte("ready\n"))
	})

	server := &http.Server{
		Addr:              ":8080",
		Handler:           mux,
		ReadHeaderTimeout: 5 * time.Second,
	}

	serverErr := make(chan error, 1)
	go func() {
		serverErr <- server.ListenAndServe()
	}()

	select {
	case <-rootCtx.Done():
	case err := <-serverErr:
		if !errors.Is(err, http.ErrServerClosed) {
			log.Error("http server failed", "error", err)
		}
		stop()
	}

	ready.Store(false)

	shutdownCtx, cancel := context.WithTimeout(
		context.Background(),
		15*time.Second,
	)
	defer cancel()

	if err := server.Shutdown(shutdownCtx); err != nil {
		log.Error("http shutdown failed", "error", err)
	}

	// 停止健康检查和后台 Worker,确保不再借出连接。
	stop()
	wg.Wait()

	// Close 会等待借出连接归还;应放在流量和 Worker 停止之后。
	pool.Close()
}
14.3 代码审查结论
上述示例体现了以下边界:
DATABASE_URL来自环境;- 只使用
$1参数,不拼接用户输入; - Pool 在启动时通过 Ping 验证;
Rows显式关闭并检查Err;BatchResults的 Close 错误未丢弃;- 事务有 Rollback 兜底;
- Commit 错误被标记为结果可能未知;
- Tracer 不记录参数;
- readiness 与 liveness 分离;
- Pool 统计可观测;
- 关闭顺序是停止流量、停止 Worker、等待 goroutine、关闭 Pool。
15. 生产排障 Runbook
15.1 首先确认
- 是所有实例、单个实例还是单个租户?
- 错误发生在 Acquire、SQL、结果读取还是 Commit?
- 是否伴随发布、扩容、Failover、证书轮换或网络变更?
- SQLSTATE 是什么?
AcquiredConns是否接近MaxConns?EmptyAcquireWaitTime和CanceledAcquireCount是否增长?- PostgreSQL 实际连接数是否达到上限?
- 是否存在长事务或
idle in transaction?
15.2 应用指标
优先查看:
request_duration_seconds
db_acquire_duration_seconds
db_query_duration_seconds
db_transaction_duration_seconds
pgxpool_acquired_conns
pgxpool_idle_conns
pgxpool_constructing_conns
pgxpool_empty_acquire_total
pgxpool_empty_acquire_wait_seconds_total
pgxpool_canceled_acquire_total
pgxpool_new_connections_total
errors_by_sqlstate
判断:
- Acquire P99 上升、SQL 时间稳定:Pool 或准入瓶颈;
- SQL P99 上升、Acquire 稳定:数据库执行问题;
- 两者都上升:长查询、锁或 I/O 正在占满连接;
- NewConns 激增:连接轮换、网络抖动或 Failover;
- Idle 很多但请求慢:不是 Pool 容量不足。
15.3 数据库连接分布
SELECT
    application_name,
    state,
    wait_event_type,
    wait_event,
    count(*) AS connections
FROM pg_stat_activity
WHERE backend_type = 'client backend'
GROUP BY
    application_name,
    state,
    wait_event_type,
    wait_event
ORDER BY connections DESC;
15.4 长事务
SELECT
    pid,
    application_name,
    usename,
    state,
    xact_start,
    clock_timestamp() - xact_start AS xact_age,
    query_start,
    wait_event_type,
    wait_event,
    left(query, 160) AS query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
关注:
xact_age;idle in transaction;- 是否来自后台任务;
- 是否长期持有同一个 Pool 连接。
15.5 blocker
SELECT
    blocked.pid AS blocked_pid,
    blocked.application_name AS blocked_application,
    blocked.wait_event_type,
    blocked.wait_event,
    pg_blocking_pids(blocked.pid) AS blocking_pids,
    clock_timestamp() - blocked.query_start AS blocked_for,
    left(blocked.query, 160) AS blocked_query
FROM pg_stat_activity AS blocked
WHERE cardinality(pg_blocking_pids(blocked.pid)) > 0
ORDER BY blocked.query_start;
随后检查 blocker:
SELECT
    pid,
    application_name,
    state,
    xact_start,
    clock_timestamp() - xact_start AS xact_age,
    left(query, 160) AS query
FROM pg_stat_activity
WHERE pid = ANY($1::integer[]);
诊断工具中必须使用参数数组传入 PID,不要拼接 SQL。
15.6 连接预算
SELECT name, setting
FROM pg_settings
WHERE name IN (
    'max_connections',
    'reserved_connections',
    'superuser_reserved_connections'
)
ORDER BY name;
SELECT count(*) AS client_backends
FROM pg_stat_activity
WHERE backend_type = 'client backend';不能只看 max_connections,还需确认:
- 每个应用实例数;
- 每实例
MaxConns; - 发布期间实例峰值;
- PgBouncer Server Pool;
- 监控、迁移、备份和 DBA 连接。
15.7 找到最早计划估算错误
本章主要是连接层,但 Pool 耗尽可能由慢计划引起。
步骤:
- 从 Trace 或
pg_stat_statements找到占用总时间最高、P99 最差的 Query Name; - 使用代表性参数在可控环境执行:
EXPLAIN (
    ANALYZE,
    BUFFERS,
    WAL,
    SETTINGS,
    VERBOSE,
    SUMMARY
)
SELECT ...;- 从最内层节点向上找第一处
Actual Rows与Rows出现数量级偏差的位置; - 检查
loops; - 检查 Sort、Hash、Temporary File;
- 结合 Wait Event、CPU 和 I/O。
不要在普通请求路径自动执行 EXPLAIN ANALYZE。对写语句它会真正执行;即便放在 BEGIN/ROLLBACK 中,Sequence、外部系统和某些触发器副作用也未必完全回滚。
15.8 故障分类
| 现象 | 优先判断 |
|---|---|
| CPU 高、Pool 满 | 查询并发超过性能拐点、坏计划、并行过多 |
| I/O 高、Pool 满 | 缓存未命中、扫描量上升、随机 I/O 饱和 |
| 锁等待高 | 热点行、长事务、DDL、固定锁顺序问题 |
| Pool 满、数据库 active 少 | 应用在事务中做慢处理、Rows 泄漏 |
53300 | 全局连接预算失控 |
| NewConns 高 | 网络抖动、寿命过短、连接风暴 |
| WAL 高 | 写吞吐、批量更新、索引维护 |
| Vacuum 落后 | 长事务和写放大间接占池 |
| Replica Lag 高 | 写负载、长事务、重放资源不足 |
25006 | Writer 地址指向只读节点 |
08007/40003 | 结果不确定,启动对账流程 |
15.9 在线安全操作
通常可在线执行:
- 查询
pg_stat_activity; - 查询
pg_locks; - 读取
Pool.Stat(); - 暂停后台任务;
- 降低应用并发;
- 限制新流量;
- 对已确认的异常 Pool 执行一次受控 Reset;
- 取消明确的非关键长查询。
高风险操作:
- 批量
pg_terminate_backend; - 同时重启所有应用;
- 无差别
Pool.Reset(); - 临时放大所有实例
MaxConns; - 取消未知业务事务;
- Failover 后直接重放写请求;
- 在事故期间修改多个超时和池参数而无基线。
15.10 临时止损
- 暂停后台批处理;
- 下调应用 Admission 并发;
- 对非关键接口 Load Shedding;
- 缩短新请求的队列预算,而不是强杀在途事务;
- 隔离热点租户;
- 启用只读降级;
- 限制重试速率;
- 保留 DBA 连接。
15.11 根本修复
- 修复 Rows/Tx/Batch 泄漏;
- 将慢外部服务移出事务或改为 Outbox;
- 为在线和后台任务设置独立预算;
- 重新推导
MaxConns; - 修复慢计划和索引;
- 减少热点竞争;
- 为 Failover 增加抖动和幂等;
- 按 Pooling 模式消除会话依赖。
15.12 验证
- Acquire P95/P99 回到基线;
CanceledAcquireCount增量归零或恢复正常;AcquiredConns不再长期贴近上限;- 长事务和 blocker 消失;
- NewConns 速率稳定;
- 错误率和业务不变量正常;
- 进行相同负载的回归压测。
16. 常见错误与反模式
-
每个请求创建一个 Pool Pool 应是进程级长生命周期对象。
-
把
MaxConns设置成 goroutine 数 goroutine 是上游并发,不是数据库容量。 -
把 Pool 当成吞吐放大器 Pool 的首要作用是复用、限制和排队。
-
多个 goroutine 共用同一个
pgx.Connpgx.Conn不支持并发调用。 -
忘记
Rows.Close()或rows.Err()会泄漏连接或丢失流式读取阶段错误。 -
忘记关闭
BatchResults可能让连接停留在不可复用的协议状态。 -
事务内调用慢外部服务 同时延长连接、Snapshot 和锁占用。
-
把
Ping放在每个业务请求前 增加额外往返,也不能消除 Commit 结果不确定。 -
Transaction Pooling 下依赖 Session State 包括
SET、LISTEN、持久临时表和 Session Advisory Lock。 -
对所有错误自动重试或每次错误执行 Reset 会重复业务写入并制造重连风暴。
17. 模拟生产事故案例
案例一:发布导致连接风暴
模拟生产案例
系统背景
- PostgreSQL
max_connections=400; - 20 个应用实例;
- 每实例
MaxConns=30、MinIdleConns=20; - 滚动发布时新旧实例重叠;
- 无 PgBouncer。
故障现象
- 发布后
53300 too_many_connections; - readiness 大量失败;
- 新旧实例反复重启;
- 数据库认证 CPU 升高;
- 正常实例也开始失去连接。
错误假设
“Pool 最多才 30,不算多,而且连接会按需建立。”
实际最低空闲目标已造成:
40 个重叠实例 × 20 = 800 个预期空闲连接排查过程
- 按
application_name聚合pg_stat_activity; - 发现发布版本连接数同步增长;
NewConnsCount在所有实例激增;- 数据库 SQL 本身并不慢;
- 连接主要处于
idle。
根因
单实例配置未乘以发布峰值实例数,MinIdleConns 造成同步建连。
临时止损
- 暂停发布;
- 限制新实例并发启动;
- 降低 MinIdle;
- 保留旧健康实例;
- 对非关键流量降载。
最终修复
- 用峰值 40 个实例推导全局预算;
- 将
MaxConns下调; - 将
MinIdleConns设置为经过测量的低值; - 加入启动 Jitter;
- 引入 PgBouncer Transaction Pooling;
- 保留运维连接槽位。
监控补充
- 所有实例
MaxConns配置总和; NewConnsCount速率;- 数据库按
application_name的连接数; - 发布期间峰值实例数;
53300告警。
防止复发
把连接预算检查加入发布准入:
预计峰值实例数 × 单实例 MaxConns
<= 分配给该服务的全局连接预算
案例二:Rows 泄漏导致 Pool 耗尽
模拟生产案例
系统背景
订单导出接口读取大量行,Pool MaxConns=20。
故障现象
- 数据库 CPU 正常;
- PostgreSQL active 查询不多;
- 应用 Acquire P99 持续上升;
AcquiredConns=20;CanceledAcquireCount增长。
错误假设
“查询已经返回,连接应该自动回池。”
排查过程
- 数据库
pg_stat_activity多条连接为idle; - 应用 Pool 显示全部 Acquired;
- Goroutine Profile 指向导出函数;
- 发现循环在达到业务限制后直接返回;
- 函数没有
defer rows.Close()。
根因
结果集未关闭,连接仍被调用方持有。
临时止损
- 下线导出接口;
- 重启少量实例释放泄漏;
- 限制导出并发;
- 不扩大 MaxConns 掩盖问题。
最终修复
rows, err := pool.Query(ctx, sql, args...)
if err != nil {
	return err
}
defer rows.Close()

for rows.Next() {
	// ...
}
return rows.Err()
同时为导出任务设置独立 Pool 或 Semaphore。
监控补充
- Pool Acquired;
- Acquire P99;
- 长时间持有租约的 Tracer;
- 导出任务并发数;
- Goroutine 数。
防止复发
- Code Review 检查 Rows、Tx、Batch 生命周期;
- 静态分析和集成测试;
- 故意提前退出循环的测试;
- Pool 耗尽回归实验。
18. 面试题
18.1 核心概念题
题 1:pgx.Conn 和 pgxpool.Pool 有什么区别?
30 秒回答: pgx.Conn 是单个 PostgreSQL 会话,不支持多个 goroutine 并发使用;pgxpool.Pool 管理多个连接并支持并发 Acquire。
深入回答: Conn 适合 LISTEN、迁移或专用会话;Pool 适合 API 服务。Pool 能限制并发,但不能修复慢 SQL。缺点是增加租约、排队和生命周期管理。替代方案是 database/sql 或 PgBouncer,但仍要计算总连接预算。
考察: 是否真正理解连接与池。
错误回答: “Conn 和 Pool 都是并发安全的。”
追问: 一个事务是否可以跨两个 Pool 连接?
答案: 不可以。事务绑定一个物理会话,必须通过同一个 Tx 执行。
题 2:goroutine 数为什么不应等于连接数?
30 秒回答: goroutine 是应用并发,连接是数据库并发预算;两者应通过 Pool 和准入队列解耦。
深入回答: 高于数据库最佳活跃并发后,更多连接只会增加 CPU 调度、锁和 I/O 排队。优点是 Pool 能提供背压;缺点是会增加排队延迟,因此还需超时和 Load Shedding。替代方案是 PgBouncer,但它也不能突破数据库执行容量。
错误回答: “连接越多 TPS 越高。”
追问: 如何找最佳值?
答案: 在代表性数据和硬件上增加活跃查询并发,找到吞吐停止增长、P99 或资源队列开始恶化的拐点。
题 3:MinConns 与 MinIdleConns 有何区别?
30 秒回答: MinConns 约束池总连接下限;MinIdleConns 目标是维持可立即借出的空闲连接,更直接用于降低突发请求的建连尾延迟。
深入回答: MinIdle 太高会引发启动或 Failover 连接风暴;太低则第一波请求承担建连成本。应结合实例峰值、TLS 成本和 SLO 测量。
错误回答: “两个参数完全相同。”
追问: 是否应该等于 MaxConns?
答案: 通常不应。除非有明确测量和数据库预算,否则会让所有实例常驻最大连接数。
题 4:连接、会话和事务有什么区别?
30 秒回答: 连接承载会话;会话可执行多个事务;事务只覆盖 Begin 到 Commit/Rollback。
深入回答: 会话状态可跨事务保留,因此在 Transaction Pooling 下会失效。事务内锁、Snapshot 和 SET LOCAL 只存在于当前事务。
错误回答: “一个连接只能执行一个事务。”
追问: 临时表属于哪个边界?
答案: 通常属于会话;ON COMMIT DROP 可把生命周期限制到事务,但仍需核对 Pooling 模式。
题 5:为什么必须检查 rows.Err()?
30 秒回答: Query 成功只表示查询已启动,网络、解码或服务端错误可能在迭代过程中才出现。
深入回答: Rows.Close() 负责释放连接,rows.Err() 负责报告流式读取错误。替代方案 CollectRows 可自动关闭,但仍会返回错误并可能一次性占用更多内存。
错误回答: “Query 没有返回 error 就不会再错。”
追问: 提前退出循环怎么办?
答案: 立即 Close,通常通过 defer rows.Close() 保证。
18.2 原理与排障题
题 6:Pool 满时请求在哪里等待?
30 秒回答: 等待发生在应用 pgxpool,尚未发送到 PostgreSQL,因此数据库 Wait Event 看不到它。
深入回答: 需要同时监控 Acquire Histogram、EmptyAcquireWaitTime、CanceledAcquireCount 和数据库活动。优点是保护数据库;风险是队列过长导致超时堆积。
错误回答: “会显示为 PostgreSQL Lock 等待。”
追问: 如何证明?
答案: 将 MaxConns 设为 2,占满连接后发起第三个 Acquire,并对比 Pool Stats 与 pg_stat_activity。
题 7:为什么数据库 active 少但 Pool 仍可能耗尽?
30 秒回答: 已借出连接可能在应用代码、结果读取、慢外部调用或 idle transaction 中,而非正在执行 SQL。
深入回答: 对比 AcquiredConns 与 pg_stat_activity.state,再查 Goroutine Profile、事务时长和 Rows 生命周期。
错误回答: “数据库 active 少说明 Pool 一定有空闲。”
追问: 最常见代码问题是什么?
答案: Rows 未关闭、事务未结束、BatchResults 未关闭、事务内慢外部调用。
题 8:如何处理 Commit 返回网络错误?
30 秒回答: 将结果视为未知,不能直接断言回滚,也不能盲目重试业务写入。
深入回答: 使用 Idempotency Key、业务唯一约束、状态查询和 Outbox。08007、40003 应进入对账路径。优点是避免重复订单;代价是业务模型更复杂。
错误回答: “Commit error 就重新执行整个请求。”
追问: 40001 呢?
答案: 它表示事务被回滚,可在满足幂等与重试预算时重新执行完整事务。
题 9:AcquireDuration 很高说明什么?
30 秒回答: 说明调用方获取连接耗时高,但还需判断是 Pool 空、建连慢还是健康检查慢。
深入回答: 查看 EmptyAcquire、Constructing、NewConns、DNS/TLS 指标和数据库连接数。累计平均不能代替 P99。
错误回答: “一定是 SQL 慢。”
追问: SQL 慢能否间接导致 Acquire 慢?
答案: 能。SQL 长时间占用连接,后续请求会在 Pool 排队。
题 10:PgBouncer Transaction Pooling 对 pgx Prepared Statement 有什么影响?
30 秒回答: 不能再笼统说完全不支持。现代 PgBouncer 可跟踪协议级命名 Prepared Statement,但需要核对配置;SQL PREPARE 和多数会话状态仍不兼容。
深入回答: 可选择 PgBouncer Prepared 支持、QueryExecModeExec,或在受限代理下退回 Simple Protocol。每种方案在 RTT、类型编码和兼容性上有取舍。
错误回答: “所有 Prepared Statement 都必须关闭。”
追问: DescribeExec 为什么也可能有代理问题?
答案: 它可能需要多个往返;若代理在两轮之间把客户端映射到不同 Backend,描述与执行状态可能不一致。
题 11:什么时候使用 Pool.Reset()?
30 秒回答: 在确认全局连接状态已失效,例如网络中断或服务器状态切换后,受控关闭池中连接并让后续请求重建。
深入回答: 单条业务错误不应 Reset;否则所有实例可能同时重连。替代方案是让池自然剔除坏连接。
错误回答: “任何 SQL error 都 Reset。”
追问: 已借出连接怎么办?
答案: Reset 时可继续被持有,但归还时会关闭。
18.3 架构设计题
题 12:如何为 50 个实例设计连接预算?
30 秒回答: 从数据库总上限扣除保留和其他工作负载,再除以发布、扩容和故障峰值实例数,并与压测得到的性能拐点取较小值。
深入回答: 还要拆分 Writer、Reader、后台任务和运维连接。引入 PgBouncer 可降低 Backend 数,但应用 Pool 仍需有界。
错误回答: “每实例默认 100 个连接。”
追问: 发布时为什么不能只按正常 50 个实例算?
答案: 滚动发布可能同时存在新旧实例,Failover 或自动扩容还可能进一步放大实例数。
题 13:在线请求和后台任务是否应共用 Pool?
30 秒回答: 低负载时可共用,但必须有独立并发预算;高风险系统应使用独立 Pool 或 Bulkhead。
深入回答: 独立 Pool 提供强隔离,但增加常驻连接和重连复杂度;单 Pool 配 Semaphore 更节省连接,但隔离较弱。
错误回答: “只要 MaxConns 足够大就没问题。”
追问: 如何防止后台任务饿死?
答案: 为后台保留小型固定预算,并为在线请求设置更高优先级和独立超时。
题 14:如何设计 Failover 后的应用恢复?
30 秒回答: 使用稳定 Writer Endpoint、短 Connect Timeout、旧连接剔除、带 Jitter 的有界重连、readiness、幂等写入和 Load Shedding。
深入回答: TCP 连接不会迁移;Commit 结果可能未知;所有实例不能同时 Reset 和全速重试。Pool 只负责连接恢复,不能替代 Fencing 或复制一致性。
错误回答: “驱动会把所有事务自动切到新主库。”
追问: 是否重试所有失败 SELECT?
答案: 只读且无副作用的 SELECT 通常更适合有限重试,但仍需遵守 Context 和全局背压。
题 15:如何设计数据库健康检查?
30 秒回答: Liveness 不依赖数据库;Readiness 使用后台、低频、短超时的 Ping 或轻量查询缓存结果。
深入回答: 每请求 Ping 增加 RTT;高频探针会形成负载。Failover 时 readiness 应及时失败,恢复时要有抖动,避免所有实例同步建连。
错误回答: “数据库不通就让 Kubernetes 不断重启应用。”
追问: 为什么重启可能更糟?
答案: 它会销毁现有健康状态并触发更多 TLS、认证和 Backend 创建,形成 Connection Storm。
19. 练习和参考答案
19.1 理论题
1. MaxConns=20 是否表示数据库始终有 20 条连接?
答案: 不一定。它是上限;实际连接数受请求、MinConns、MinIdleConns、空闲回收和连接寿命影响。
2. AcquiredConns=20 是否表示有 20 条 SQL 正在执行?
答案: 不一定。连接可能处于应用处理、结果读取、事务间隙或慢外部调用。
3. 为什么 Pool.Close() 可能长期阻塞?
答案: 它等待借出的连接归还。应先停止新流量、取消 Worker 并等待请求退出。
4. 23505 是否应该自动重试?
答案: 通常不应。它多为业务唯一性冲突;只有在明确的并发分配算法中才可能有受控重试。
5. 为什么不能把 search_path 当成普通业务请求状态?
答案: 它属于会话状态;在连接复用和 Transaction Pooling 下可能由其他请求或不同 Backend 承载。应使用 Schema 限定 SQL。
19.2 实验题
1. 将 MaxConns 从 2 逐步增加到 32,记录吞吐和 P99。
参考方法:
- 固定数据、查询和硬件;
- 每档充分 Warm-Up;
- 保持测试时长一致;
- 记录 Acquire、SQL、CPU、I/O、Wait Event;
- 找到吞吐增益消失而 P99 开始恶化的拐点;
- 不以单次结果作为生产结论。
2. 故意在 Rows 循环第十行提前返回但不 Close。
预期:
- Pool Acquired 持续增长;
- 数据库连接可能显示 idle;
- 最终 Acquire 超时;
- 加上
defer rows.Close()后恢复。
3. 在 Transaction Pooling 下测试 Session State。
依次测试:
SET application_name = 'changed';
CREATE TEMP TABLE temp_test(id integer);
LISTEN demo;
SELECT pg_advisory_lock(1);
参考答案: 根据 PgBouncer 当前 Feature Map 判断哪些状态不能跨事务依赖;协议级 Prepared Statement 还需核对 max_prepared_statements。
19.3 排障题
1. Pool Acquired=Max,数据库 CPU 低,active 查询很少。
参考答案:
- 查
idle in transaction; - 查 Rows、Tx、Batch 泄漏;
- 查事务内外部调用;
- 查 Goroutine Profile;
- 暂停相关接口;
- 修复资源生命周期,而不是先扩大 Pool。
2. Failover 后所有实例出现大量 53300。
参考答案:
- 检查所有实例同步重连;
- 检查
MinIdleConns; - 检查是否每个错误都调用 Reset;
- 降低准入和重连速率;
- 保留部分实例逐步恢复;
- 从峰值实例重新计算预算;
- 引入 PgBouncer 或分批重建。
19.4 系统设计题
设计一个订单服务数据库访问层
条件:
- 正常 20 个实例,发布峰值 30 个;
- Primary 总连接上限 500;
- 需保留 100 个给复制、运维和其他服务;
- 订单请求 P99 目标 200ms;
- 后台对账任务吞吐高但优先级低;
- 有一个只读副本。
参考设计:
Primary 可分配预算:400
订单服务分配:300
其他预留:100

峰值实例数:30
Primary 理论每实例预算:10
压测拐点:假设每实例 8
Writer Pool MaxConns:8

Replica 单独核算预算
Reader Pool:按副本容量设置,例如每实例 4,但必须重新核算副本总预算

后台任务:
优先选择独立 Semaphore,最多使用每实例 1~2 条 Writer 连接;
若隔离要求高,建立小型独立 Pool,但总预算不能重复计算。
设计还应包括:
- Schema 限定 SQL;
- Query Name 和 Tracer;
- Acquire 与 Query 分段超时;
- Idempotency Key;
- Commit Unknown 对账;
- Failover Jitter;
- readiness/liveness;
- 在线和后台 Bulkhead;
- Pool Stats 告警;
- Replica 过期读取策略。
20. 检查清单
- 我能够解释 goroutine、连接、Backend、活跃查询和 TPS 的区别。
- 我能够根据全局连接预算和峰值实例数推导
MaxConns。 - 我能够说明
MinConns与MinIdleConns的差异。 - 我能够正确关闭
Rows并检查rows.Err()。 - 我能够正确关闭
BatchResults。 - 我能够使用
BeginTx、Rollback 兜底并单独检查 Commit。 - 我不会因为 Commit 返回错误就断言事务一定未提交。
- 我能够使用
errors.As和*pgconn.PgError分类 SQLSTATE。 - 我能够通过 Pool Stats 识别 Acquire 排队和连接风暴。
- 我能够复现连接池耗尽。
- 我能够定位长事务、blocker 和事务内慢外部调用。
- 我能够解释
pgx.Conn为什么不能由多个 goroutine 并发使用。 - 我能够解释 Transaction Pooling 下的会话状态限制。
- 我能够为 Failover 设计重连退避、Jitter 和 Load Shedding。
- 我能够区分 readiness 与 liveness。
- 我能够分析连接池对 CPU、内存、I/O、WAL 和 P99 的间接影响。
- 我能够在 Go 中实现有界并发、Pool 预热和优雅关闭。
- 我能够验证修复,而不是仅通过扩大连接数止损。
21. 原结论检查结果
你给出的第 16 章范围总体正确,但建议做以下精确修订:
- 技术基线结论成立:截至 2026 年 6 月 20 日,PostgreSQL 18 是稳定主版本,精确维护版本为 18.4;PostgreSQL 19 是 Beta 1。(PostgreSQL)
- 将配置项 “Lifetime Jitter” 精确写为
MaxConnLifetimeJitter。 MinConns和MinIdleConns不能并列而不解释差异;维持请求可立即使用的空闲容量时,当前 pgxpool 文档明确更推荐MinIdleConns。(Go Packages)PrepareConn应作为当前 API 讲解重点;旧的BeforeAcquire已标记为 Deprecated。(Go Packages)PingTimeout是当前 Pool 配置字段,但它不能替代业务 Context、Connect Timeout 或statement_timeout。AcquireDuration、EmptyAcquireWaitTime是累计值,不能直接当作 P95/P99;生产必须另建 Histogram。EmptyAcquireCount只统计等待后成功获取的情况;Context 取消由CanceledAcquireCount统计。(Go Packages)Pool.Close()会等待借出连接归还;优雅关闭顺序必须先停止流量和 Worker。Pool.Reset()保持 Pool 可用,只关闭当前连接。(Go Packages)- PgBouncer Prepared Statement 结论必须写成版本和配置相关,不能继续笼统地说 Transaction Pooling 完全不支持 Prepared Statement。(PgBouncer)
- “连接池是并发安全的”不能外推为“池里取得的
pgx.Conn也是并发安全的”;后者不成立。(Go Packages)